
TypeSafe เปิดตัว Jev ด้วยเดโมที่คนพูดถึงมากที่สุด: ให้โมเดลเล่น Doom โดยตัดสินใจ ~10 ครั้งต่อวินาทีจาก “ข้อความบรรยายสถานการณ์” ไม่ใช่ภาพ ในราคา ~$7 ต่อชั่วโมง เราอยากรู้ว่าฟีเจอร์ Classify ของ AI Server (ที่ใช้โมเดลในเครื่องลูกค้าอยู่แล้ว ไม่มีโมเดลใหม่) ทำแบบเดียวกันได้ไหม บทความนี้คือบันทึกทั้งวัน: เครื่องมือที่ใช้ โค้ดส่วนสำคัญ ตัวเลขทุกรอบ และบั๊ก 3 ตัวที่สอนเรามากกว่าผลลัพธ์สุดท้าย (สถานะ: เดโมทำงานบนเครื่อง DGX Spark ของเรา ดูผ่านเครือข่ายภายใน ยังไม่ขึ้นเว็บสาธารณะ)
ตอนที่ 1: ทำไมต้องเป็น Doom
Doom เป็นเกมที่ “การตัดสินใจถูกต้อง” วัดได้ทันที: ฆ่าศัตรูได้กี่ตัว รอดนานแค่ไหน และมันต้องการการตัดสินใจถี่มาก (เกมเดิน 35 เฟรมต่อวินาที) ถ้าโมเดลใช้เวลาตอบ 2 วินาทีแบบแชตปกติ ตัวละครตายก่อนได้คำตอบ
นี่คือจุดที่ “ตัดสินใจโดยไม่ generate” มีความหมายจริง: เราไม่ต้องการให้โมเดลอธิบายว่าทำไมควรหันซ้าย เราต้องการแค่ตัวอักษรเดียวกับความมั่นใจ แล้วรอบถัดไปมาถึงใน 100 มิลลิวินาที
สิ่งที่เราอยากพิสูจน์ 3 ข้อ:
- โมเดลใน AI Server (Qwen3-8B และ Qwen3.6-35B ที่ลูกค้าโหลดอยู่แล้ว) ตัดสินใจได้เร็วพอสำหรับเกม
- มันตัดสินใจ “ดีกว่ากฎที่คนเขียน” ได้ไหม โดยที่เราไม่ต้องเขียนกฎเลย
- ต้องเขียนอะไรบ้าง และส่วนไหนยาก
ตอนที่ 2: เครื่องมือ
- ViZDoom 1.3.0 ไลบรารี Python ที่ห่อ ZDoom ให้เรียกเกมทีละเฟรม อ่านค่าภายใน (เลือด กระสุน ตำแหน่งวัตถุ) และสั่งปุ่มได้ มาพร้อม freedoom (WAD ฟรี) ไม่ต้องซื้อเกม มี wheel สำหรับ ARM64 ติดตั้งบน Spark ได้ตรงๆ
- DGX Spark GB10 เครื่องเดียวกับที่ส่งลูกค้า
- vLLM รัน Qwen3-8B FP8 และ Qwen3.6-35B-A3B NVFP4 (โมเดลในชุด AI Server)
- Classify ท่าที่ใช้ตลอด: ส่ง chat request ปกติ ตั้ง
max_tokens=1, ขอlogprobs, และบังคับ token แรกให้เป็นตัวเลือกเท่านั้นด้วยstructured_outputs(บน llama.cpp ใช้ grammar) นี่คือกลไกเดียวกับโมเดล-classifyในบทความก่อนหน้า - หน้าเว็บสด: FastAPI ส่งภาพเกมเป็น MJPEG และส่งการตัดสินใจเป็น Server-Sent Events
ทั้งหมดอยู่ในไฟล์เดียว doom_agent.py ราว 200 บรรทัด กับ web.html อีก 40 บรรทัด
ตอนที่ 3: วงจรการทำงาน
ทุกๆ 4–5 เฟรมของเกม (ประมาณ 7–9 ครั้งต่อวินาที):
เกม (ViZDoom) ──state ตัวเลข──▶ แปลงเป็นข้อความไทย ──▶ Classify (โมเดล ตอบ 1 token + ความน่าจะเป็น)
   ▲                                                                   │
   └──────────────── กดปุ่ม (หันซ้าย/หันขวา/ยิง/เดิน…) ◀──────────────┘
หลักการที่ยืมมาจากทุกโปรเจกต์ Jev ในชุมชน: โค้ดธรรมดาเป็นคนบอก “ข้อเท็จจริง” และ “ทางเลือกที่ถูกกฎ” ส่วนโมเดลเป็นคนเลือก โค้ดไม่ตัดสินใจว่าควรยิงเมื่อไหร่ โมเดลไม่ต้องรู้ว่าปุ่มไหนคืออะไร
ตอนที่ 4: ขั้นที่ 1 ทำให้เกมรันโดยไม่มีจอ
import vizdoom as vzd
g = vzd.DoomGame()
g.load_config(".../scenarios/defend_the_center.cfg")
g.set_window_visible(False)
g.set_screen_resolution(vzd.ScreenResolution.RES_640X480)
g.set_labels_buffer_enabled(True)      # รายชื่อวัตถุที่อยู่ในจอ พร้อมตำแหน่ง
g.set_objects_info_enabled(True)       # ทุกวัตถุในแมป แม้ไม่เห็น
g.set_available_game_variables([HEALTH, AMMO2, KILLCOUNT, DAMAGE_TAKEN])
g.init()
ฉากแรกที่เลือกคือ defend_the_center: ตัวละครยืนกลางห้อง ศัตรูเดินเข้ามาจากรอบด้าน ทำได้แค่ 3 อย่าง หันซ้าย หันขวา ยิง กระสุน 26 นัด เป็นโจทย์ที่ “การตัดสินใจ” ชัดที่สุด ทดสอบ 200 เฟรมใช้เวลา 0.15 วินาที เกมไม่ใช่คอขวดแน่นอน
ตอนที่ 5: ขั้นที่ 2 แปลงสถานการณ์เป็นข้อความ (ส่วนที่ยากที่สุด)
โมเดลไม่เห็นภาพ มันเห็นข้อความแบบนี้:
เลือด 64 กระสุน 22 ฆ่าแล้ว 0 เพิ่งโดนโจมตี 36
ศัตรูที่เห็น: ปีศาจชมพู(ประชิด) อยู่ขวา (ห่างจากกลาง 34%) ระยะประชิด; ทหารเลื่อยยนต์ อยู่ซ้าย ระยะไกล
การกระทำล่าสุด: ยิง → ยิง → หันซ้าย
ที่มาของแต่ละบรรทัด:
- ตัวเลขจาก game variables ตรงๆ
- “ซ้าย/ขวา/กลางเป้า” คำนวณจากตำแหน่งกึ่งกลางของ label บนจอเทียบกับกึ่งกลางจอ (640 พิกเซล) “ระยะ” ประเมินจากความสูงของ label (สูงกว่า 200 พิกเซล = ประชิด)
- “การกระทำล่าสุด” 3 ครั้งช่วยไม่ให้โมเดลสลับซ้าย-ขวาไปมา
ข้อความนี้ยาวราว 60–120 token และ นี่คือที่ที่บั๊กทั้งหมดของวันนี้ซ่อนอยู่ (ตอนที่ 8, 10)
ตอนที่ 6: ขั้นที่ 3 ถามโมเดล
body = {
  "model": "qwen36-35b", "max_tokens": 1, "temperature": 0,
  "logprobs": True, "top_logprobs": 10,
  "chat_template_kwargs": {"enable_thinking": False},
  "structured_outputs": {"choice": ["A", "B", "C"]},
  "messages": [
    {"role": "system", "content": "คุณคือระบบควบคุมตัวละครในเกม Doom แบบเรียลไทม์ … กติกา: ยิงเมื่อมีศัตรูอยู่กลางเป้า · ศัตรูอยู่ซ้ายให้หันซ้าย … ตอบด้วยตัวอักษรเดียว"},
    {"role": "user", "content": "สถานการณ์:\n<ข้อความจากตอนที่ 5>\n\nการกระทำถัดไปควรเป็นอะไร\nตัวเลือก: A) หันซ้าย  B) หันขวา  C) ยิง"}
  ]}
จาก logprobs ของ token แรกเราหยิบเฉพาะ A/B/C มาทำ softmax ได้ความน่าจะเป็นของแต่ละการกระทำ เช่น ยิง 0.56 / หันขวา 0.34 / หันซ้าย 0.03 แล้วกดปุ่มที่สูงสุด ความน่าจะเป็นนี้ไม่ได้ใช้ควบคุมเกมโดยตรง แต่มันคือสิ่งที่ทำให้หน้าเว็บ “อธิบายตัวเองได้” และช่วยจับบั๊ก
ตอนที่ 7: ขั้นที่ 4 ทำตัวเทียบก่อน แล้วค่อยวัดโมเดล
ก่อนเชื่อผลของโมเดล ต้องมีอะไรให้เทียบ เราเขียน 2 ตัว:
- สุ่ม เลือกการกระทำมั่วๆ
- กฎ 3 บรรทัด: ถ้าศัตรูใกล้กลางเป้าที่สุดอยู่ “กลางเป้า” หรือ “เล็กน้อย” ให้ยิง ไม่งั้นหันไปทางนั้น ไม่เห็นใครก็หันขวา
ผลรอบแรก (3 ตอนต่อโหมด):
| โหมด | ฆ่าเฉลี่ย | รอด (วินาทีในเกม) |
|---|---|---|
| สุ่ม | 0.67 | 9.0 |
| กฎ | 2.00 | 9.2 |
| โมเดล Qwen3-8B | 2.33 | 9.7 |
โมเดลตัดสินใจ 16–18 ครั้งต่อวินาที latency 50–52 ms ต่อครั้ง (prompt ราว 280 token) เร็วกว่าเดโมของ TypeSafe แต่ผลยังไม่น่าตื่นเต้น ทุกโหมดตายใน ~10 วินาที
ตอนที่ 8: บั๊กที่ 1 มองไม่เห็นจากตัวเลข แต่เห็นจากหน้าเว็บทันที
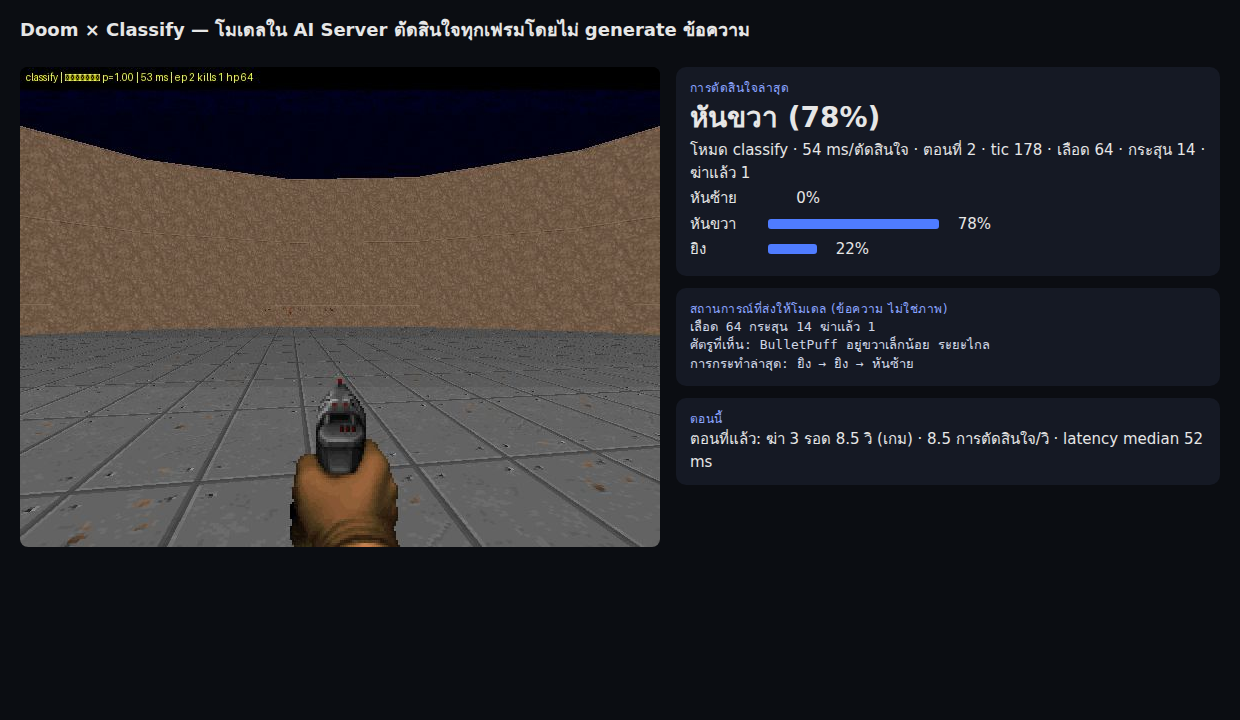
เราทำหน้าเว็บสดขึ้นมาเพื่อดูเกม แล้วตั้งใจใส่กล่อง “ข้อความที่ส่งให้โมเดล” ไว้ข้างจอ ภาพแรกที่เปิดขึ้นมาก็เห็นเลย:
ศัตรูที่เห็น: BulletPuff อยู่ขวาเล็กน้อย ระยะไกล
BulletPuff คือเอฟเฟกต์ควันตอนกระสุนกระทบผนัง ViZDoom ส่งทุกวัตถุในจอมาใน labels รวมทั้งเลือดกระเซ็นและควัน เราเอาทุกอย่างที่ไม่ใช่ผู้เล่นมาเป็น “ศัตรู” โมเดลจึงหันไปยิงควันของตัวเอง
แก้ด้วยรายชื่อมอนสเตอร์จริง (Zombieman, Demon, Imp, …) และแยก “ของเก็บได้” (ยา กระสุน) ออกเป็นอีกบรรทัด ผลหลังแก้:
| โหมด | ฆ่าเฉลี่ย | รอด |
|---|---|---|
| สุ่ม | 1.33 | 11.2 |
| กฎ | 3.67 | 9.0 |
| โมเดล Qwen3-8B | 5.33 | 15.1 |
โมเดลกระโดดจาก 2.33 เป็น 5.33 กฎก็ดีขึ้นจาก 2.0 เป็น 3.67 บทเรียนข้อแรกของวัน: คุณภาพของ “ข้อความสถานการณ์” มีผลมากกว่าโมเดล และหน้าเว็บที่โชว์สิ่งที่โมเดลเห็นคือเครื่องมือดีบักที่ดีที่สุด
ทำไมโมเดลชนะกฎ? ดูจากจำนวนการกระทำ: กฎกด “ยิง” 73 จาก 74 ครั้งจนกระสุนหมด ส่วนโมเดล “รอ” และหันบ่อยกว่า (หันซ้าย 23–44 ครั้งต่อตอน) ยิงเมื่อเห็นว่าคุ้ม
ตอนที่ 9: หน้าเว็บสดทำงานอย่างไร
ไม่มีอะไรซับซ้อน: agent เก็บเฟรมล่าสุดเป็น JPEG ไว้ในตัวแปร FastAPI ให้ /stream ส่งเป็น multipart MJPEG (เบราว์เซอร์แสดงใน <img> ได้เลย) และ /events ส่ง JSON ของการตัดสินใจล่าสุดเป็น Server-Sent Events หน้าเว็บวาดแถบความน่าจะเป็นทั้ง 3–7 การกระทำ ข้อความ state และสถิติของตอนที่แล้ว ภายหลังเพิ่มปุ่ม “เริ่มตอนใหม่” กับ “หยุดชั่วคราว” ที่ยิง POST ไปตั้ง flag ให้ loop อ่าน
โหมด real-time: หลังกดปุ่ม agent คำนวณว่าเวลาในเกมควรอยู่ตรงไหน (35 tics/วินาที) แล้วหน่วงให้ตรง ที่ 8B ใช้เวลาจริงแค่ 45% ของแต่ละรอบ ที่ 35B (112 ms) ต้องขยับเป็นตัดสินใจทุก 5 เฟรม (7 ครั้ง/วินาที) ถึงจะทันเวลาจริง
ตอนที่ 10: ย้ายไป deathmatch แล้วโมเดล “เลิกยิง” (บั๊กที่ 2 และ 3)
defend_the_center ง่ายไป เราขยับไป deathmatch: แมปใหญ่ ศัตรูหลายชนิดยิงจากไกล มีของเก็บ ทำได้ 7 อย่าง (ยิง เดินหน้า หันซ้าย หันขวา เดินซ้าย เดินขวา ถอย) รอบ 2 นาที
ผลรอบแรก: Qwen3-8B ฆ่าได้ 1.0 (กฎ 3.5) และ Qwen3.6-35B ฆ่า 1.5 แต่ ยิง 0 ครั้งจาก 1,000+ การตัดสินใจ เดินหน้าอย่างเดียว
สงสัยโมเดลก่อน จึงลองท่า “2 คำถามใน pass เดียว” (ควรยิงไหม? / ควรไปทางไหน?) ก็ยังยิง 0 เลยเอา state ที่เขียนมือไปถามตรงๆ: “ศัตรูอยู่กลางเป้า” → ตอบ “ใช่ ยิง” 0.999 / “ศัตรูอยู่ซ้าย ไกล” → “ไม่ยิง หันซ้าย” / “ไม่เห็นศัตรู” → “ไม่ยิง หันขวา” ตรรกะของโมเดลถูกทุกข้อ
งั้นบั๊กอยู่ที่ state เราเปิด log ทุกการตัดสินใจแล้วนับ: 190 การตัดสินใจ เห็นศัตรู 0 ครั้ง แมปใหญ่ ศัตรูอยู่นอกจอเกือบตลอด labels ให้เฉพาะสิ่งที่อยู่ในจอ โมเดลจึงเห็นแต่ “ไม่เห็นศัตรู” และทำตามกติกาซื่อๆ คือเดินหน้า ส่วนที่ “ฆ่าได้ 1–3” มาจากมอนสเตอร์ตีกันเอง
บั๊กที่ 2 ที่แก้ระหว่างทาง: เกณฑ์ “กลางเป้า” (เบี่ยงจากกลางจอไม่เกิน 6%) ใช้ค่าเดียวทุกระยะ ศัตรูไกลตัวเล็กไม่มีทางเข้าเกณฑ์ แก้ให้เกณฑ์ขึ้นกับระยะ (ไกล 14%, ใกล้ 10%, ประชิด 6%) และบอกตัวเลขตรงๆ “ห่างจากกลาง 34%” ให้โมเดลชั่งเอง
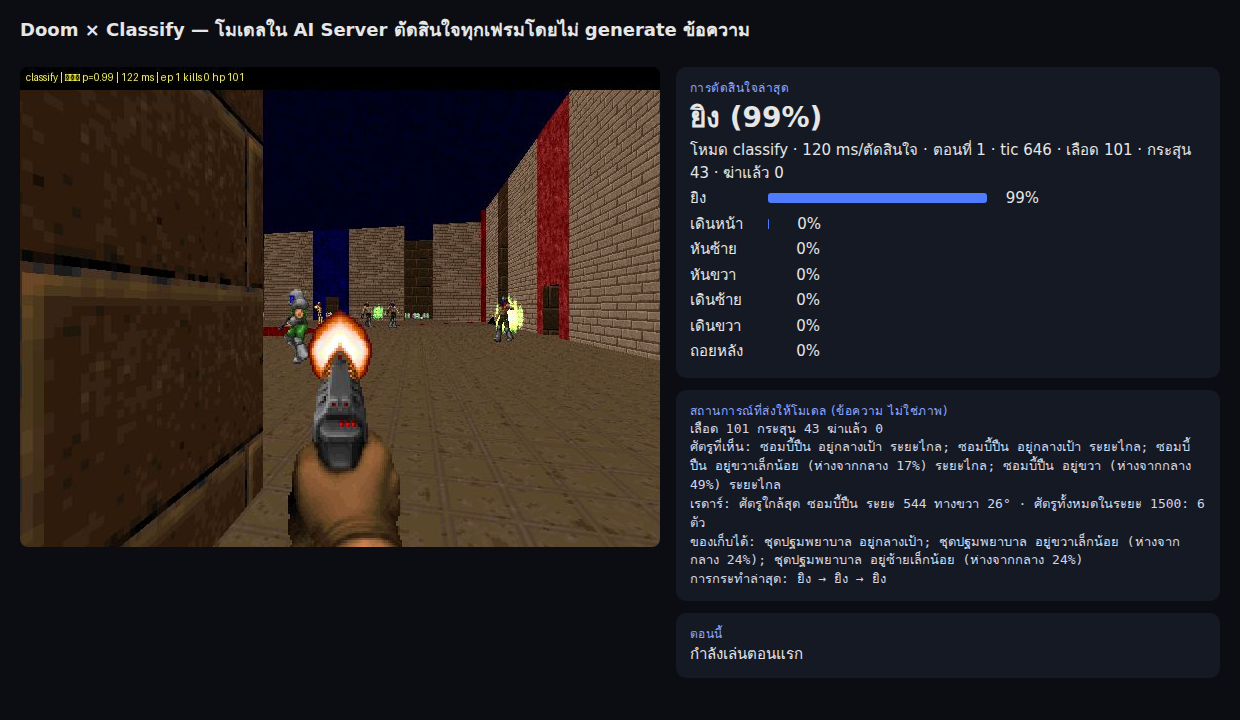
บั๊กที่ 3 แก้ด้วย “เรดาร์”: ViZDoom มี state.objects ที่บอกตำแหน่งของทุกวัตถุในแมปแม้ไม่เห็น เราเอาตำแหน่งผู้เล่นและมุมหันมาคำนวณมุมสัมพัทธ์กับระยะของศัตรูใกล้สุด แล้วเพิ่มบรรทัด:
เรดาร์: ศัตรูใกล้สุด ซอมบี้ปืน ระยะ 544 ทางขวา 26° · ศัตรูทั้งหมดในระยะ 1500: 6 ตัว
กับกติกาในระบบอีกข้อ “ไม่เห็นศัตรูให้หันตามเรดาร์ ตรงหน้าแล้วเดินเข้าไป” (TypeSafe เองก็บอกว่าเดโม Doom ใช้ “structured game state” ไม่ใช่แค่สิ่งที่เห็น)
ผลหลังใส่เรดาร์ (35B, 2 ตอน):
| โหมด deathmatch | ฆ่าเฉลี่ย | รอด |
|---|---|---|
| กฎ ยิงอย่างเดียว | 3.5 | 16 วิ |
| กฎ + เรดาร์ (หันหา เดินเข้าหา) | 1.0 | 11 วิ |
| Qwen3-8B + เรดาร์ | 0.5 | 17 วิ |
| Qwen3.6-35B + เรดาร์ | 5.0 | 23 วิ |
จาก log 406 การตัดสินใจของ 35B: เห็นศัตรู 279 ครั้ง → ยิง 267 · ศัตรูกลางเป้า 252 → ยิง 248 · ไม่เห็น 127 → เดินหน้า 77 / หันตามเรดาร์ 46 และความน่าจะเป็นมีนัยจริง: ศัตรูห่างกลาง 34% → ยิง 0.56 / หันขวา 0.34 (ลังเลถูกจุด) ห่าง 15% → ยิง 0.975
ตอนที่ 11: 8B กับ 35B ต่างกันตรงไหน และเรื่องอคติตัวอักษร
- ฉากง่าย (3 ทางเลือก): 8B 5.33 ≈ 35B 5.0 โมเดลเล็กพอ
- ฉากยาก (7 ทางเลือก + เรดาร์ + กติกา 6 ข้อ): 8B 0.5 กับ 35B 5.0 ต่างกัน 10 เท่า 8B ยิงพร่ำเพรื่อตอนศัตรูยังไม่กลางเป้า และไม่เดินหน้าเลยทั้งที่เรดาร์บอกตรงหน้า
- 8B ในฉากง่ายกด “หันซ้าย” 23–44 ครั้ง แต่ “หันขวา” 0–1 ครั้ง ทั้งที่ศัตรูมาทั้งสองข้าง ส่วน 35B สมดุล (36/65) นี่คืออคติต่อตัวเลือก A ของโมเดลเล็กที่เราเจอในบทความก่อน ทดสอบ 35B แบบสลับลำดับตัวเลือกทุกครั้งได้ 4.0 เทียบ 5.0 (อยู่ในความแปรปรวน) แปลว่า 35B ไม่ได้พึ่งลำดับ
- ท่า “2 คำถามใน pass เดียว” ทำงานถูกต้องแต่แพงกว่า (170 ms เพราะต้องใช้ prompt logprobs ทั้งก้อน) จึงกลับมาใช้ 1 คำถาม 7 ตัวเลือก
ตอนที่ 12: ตัวเลขความเร็วและต้นทุน
| โมเดล | latency ต่อการตัดสินใจ | ตัดสินใจต่อวินาที | หมายเหตุ |
|---|---|---|---|
| Qwen3-8B FP8 (vLLM) | 50–65 ms | 14–18 | prompt 280–530 token |
| Qwen3.6-35B-A3B NVFP4 (vLLM) | 88–114 ms | 8.5–10.5 | เท่าเดโม TypeSafe |
ต้นทุน: ไม่มีค่า API เพราะรันบนเครื่องลูกค้าเอง GPU ถูกใช้เต็มเวลาหนึ่งสตรีม (TypeSafe คิด ~$7 ต่อชั่วโมง) และเพราะ vLLM รวมหลายคำขอเป็น batch ได้ เครื่องเดียวน่าจะเล่นพร้อมกันได้ 4–6 เกม ซึ่งจะทดสอบต่อไป
ตอนที่ 13: บทเรียนและสิ่งที่จะทำต่อ
- โมเดลไม่ได้โง่ ข้อความสถานการณ์ต่างหากที่ไม่พอ บั๊กทั้ง 3 ตัวอยู่ที่ representation งาน “แปลงโลกเป็นข้อความ” คือ 80% ของ agent แบบนี้
- หน้าเว็บที่โชว์สิ่งที่โมเดลเห็น จับบั๊กได้เร็วกว่า log ตัวเลขทุกแบบ
- มี baseline ก่อนเสมอ ถ้าไม่มี “กฎ 3 บรรทัด” เราจะไม่รู้ว่า 2.33 ของรอบแรกแย่ และ 5.33 ของรอบสองดี
- โค้ดบอกข้อเท็จจริง โมเดลตัดสิน เราไม่ได้เขียนกฎยิง/หันเป็นโค้ดเลย แต่ 35B ทำตามกติกาในระบบได้ 98% ของครั้งที่เห็นศัตรู
- ความน่าจะเป็นมีค่ามากกว่าคำตอบ ตัวเลข 0.56 vs 0.34 บอกว่าโมเดลลังเล ซึ่งเป็นสัญญาณให้ปรับ state หรือใช้ threshold
ต่อไป: ให้ตัวละครหลบกระสุนและไปเก็บเลือด (ตอนนี้ตายใน ~23 วินาทีเพราะยืนยิงอย่างเดียว) โดยถาม 2 คำถามให้ “เคลื่อนที่พร้อมยิง”, เล่นหลายเกมพร้อมกันเพื่อวัด batch, และนำหน้าเว็บนี้ขึ้น aiserver.in.th ผ่านตัว relay แบบเดียวกับ Video Studio
สรุปประโยคเดียว: เดโมที่ TypeSafe ใช้เปิดตัวโมเดลลับ ทำได้ในหนึ่งวันด้วยโมเดลที่อยู่ในเครื่องลูกค้าเราอยู่แล้ว และสิ่งที่ยากไม่ใช่โมเดล แต่คือการบอกโมเดลว่าโลกเป็นอย่างไร
ทดสอบ 20 ก.ย. 2026 บน DGX Spark GB10 · ViZDoom 1.3.0 + freedoom · โมเดล Qwen3-8B FP8, Qwen3.6-35B-A3B NVFP4 บน vLLM · ตัวเลขทั้งหมดจากบันทึกแล็บ ผลต่อตอนแปรปรวนสูง (2–9 ตัวใน 3 ตอน) ควรอ่านเป็นแนวโน้มไม่ใช่ค่าแม่นยำ